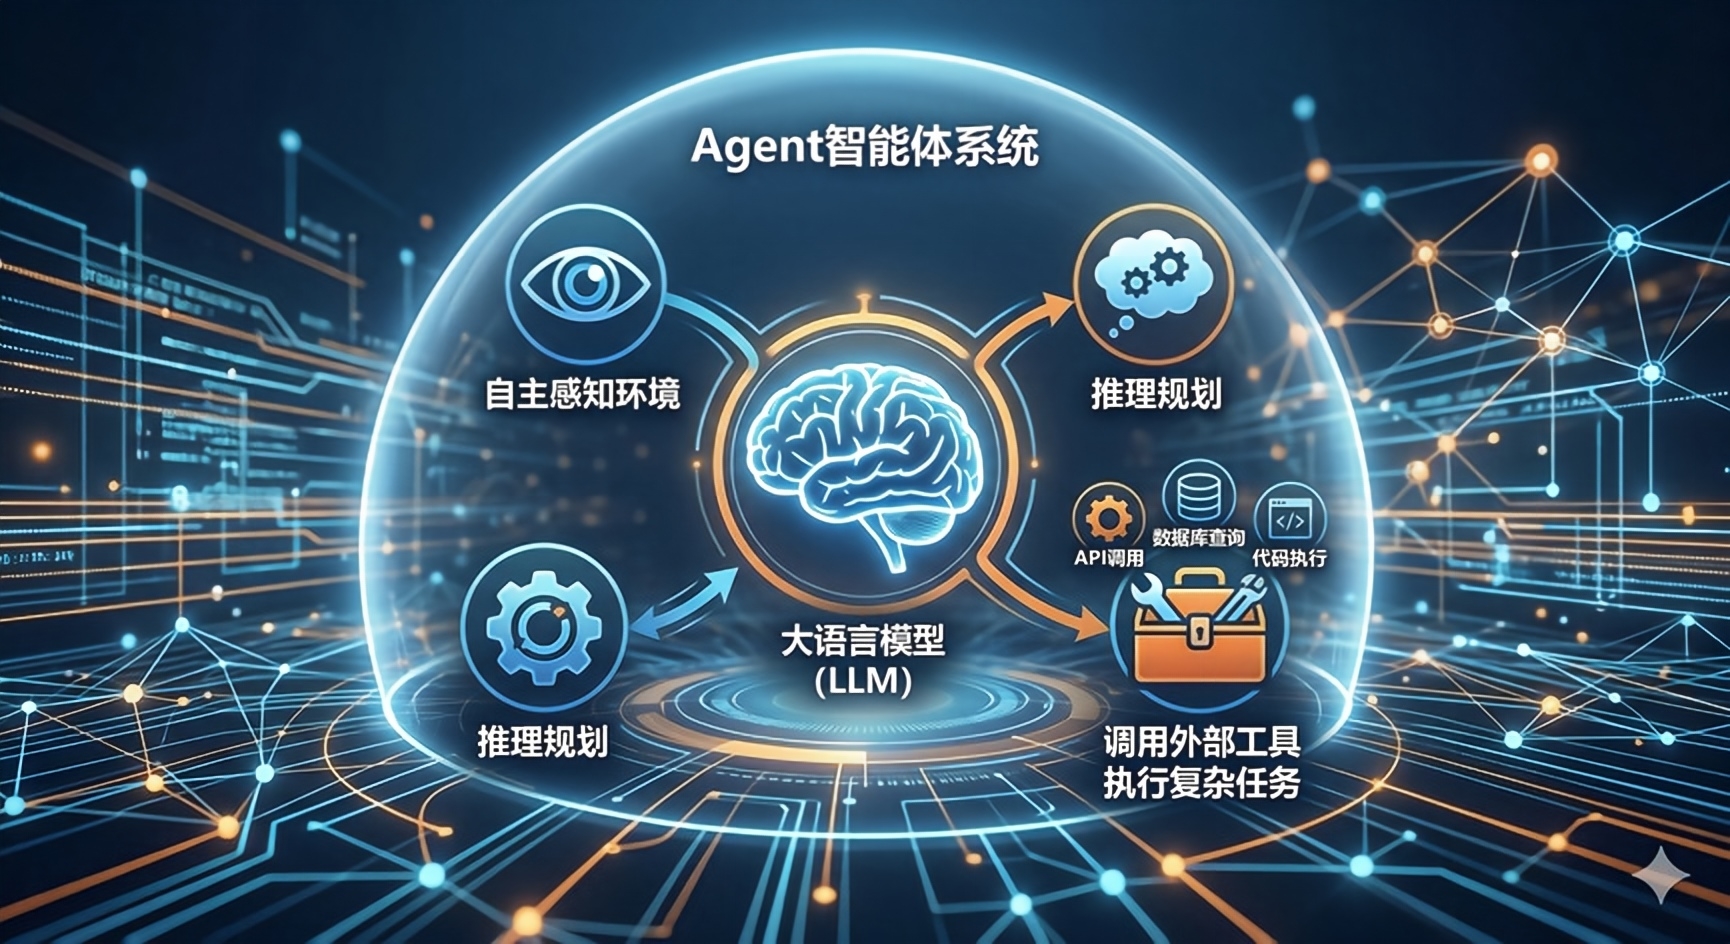

课程简介
随着大模型推理从“能用”走向“用好”,企业在生产级 AI 应用中面临的核心矛盾正在发生变化:瓶颈不再只是模型能力本身,而是如何在有限 GPU 资源、严格延迟约束和持续增长的业务请求下,高效地产生有价值的 Token。
在大模型推理系统中,Token 不只是计费单位,更是算力消耗、显存占用、请求延迟和系统吞吐的直接载体。随着模型上下文变长、Reasoning 链路加深、Agent 多轮交互变复杂,输入 token、输出 token、KV Cache、重试 token、工具调用 token 和上下文累积成本都会被持续放大。对于大规模推理平台而言,优化 token efficiency,本质上是在优化单位 GPU 算力能够产出的业务价值。
本次课程将从 AI Infrastructure 的系统视角出发,围绕业务 Agent Token 优化、推理引擎、请求路由和资源弹性等层面,系统拆解大规模推理系统中的 token 成本构成、关键效率指标和工程优化路径,帮助学员理解从单点性能优化走向端到端 Token efficiency 治理。
课程收益
1、帮助 AI 平台工程师、推理系统研发者和大模型应用架构师理解 Token 在生产级推理系统中的真实成本结构;
2、建立一套Agent 运行、推理引擎、请求路由到资源弹性的 Token efficiency 优化框架,从单次模型调用扩展到 Agent 任务的端到端业务链路,从业务 Agent 运行角度提供全局 Token Efficiency 优化思路,指导大规模推理服务的容量规划、性能调优和成本治理,避免局部优化掩盖整体浪费;
3、帮助业务和平台团队从“减少 Token 数量”转向“提升有效 Token 产出”,在质量、延迟、成本之间建立更合理的系统权衡;
4、从 prefill / decode、KV Cache、continuous batching、speculative decoding 等角度,理解推理引擎如何提升 token 生成效率;
5、通过请求分级、模型路由、上下文治理、prompt cache 和多模型协同,将不同 token 负载分配到更合适的模型和资源池;
6、利用 Token-based capacity planning、弹性伸缩、分池调度和过载保护,让 GPU 资源在真实流量波动下持续产出高价值token。
受众人群
AI平台工程师、推理系统研发者、大模型应用架构师、服务调度技术专家、云容器云智算技术专家、架构创新、AI Infra领域的架构设计专家、CTO、团队负责人,以及其他对AI Infra、系统架构设计感兴趣的从业者。
课程周期
0.5天(3H)
课程大纲
授课内容 |
一、从 AI Infra 视角重新定义 token efficiency,不停留在 prompt 压缩层面。 |
二、系统拆解 token 如何影响 GPU 算力、显存、延迟、吞吐和业务成本。 |
三、覆盖推理引擎、请求路由、资源弹性三个关键基础设施层面。 |
四、结合 Agent、多轮对话、Long Context 等真实生产场景分析 Token 膨胀问题。 |
五、提供一套可复用的大规模推理系统 token efficiency 优化框架。 |
六、分享建立从单次请求成本到端到端任务成本的优化思路。 |


 京ICP备2022035414号-1


