
课程简介
值班同学收到一条告警:某个8卡分布式训练任务的GPU利用率断崖式跌到个位数,但任务状态显示Running、日志里也没有明显报错。排查时需要逐个比对多个Pod的训练日志,同时查看调度器分配情况和GPU侧指标,才能定位到是某张卡所在节点的网络抖动拖慢了梯度同步——这类跨Pod、跨系统的联合排障,30分钟起步的耗时里,大半花在“从哪里下手”上,而这样的场景几乎每天都在Infra平台的OnCall中重演。训练集群涵盖多种分布式任务类型并行运行,推理服务数量庞大,模型发布链路复杂稳定性挑战大,人工排障经验高度依赖个人,新人上手周期长,传统OnCall模式早已难以为继。AI Agent 与 AI Infra的深度融合,正在成为新一代平台工程团队的核心命题。
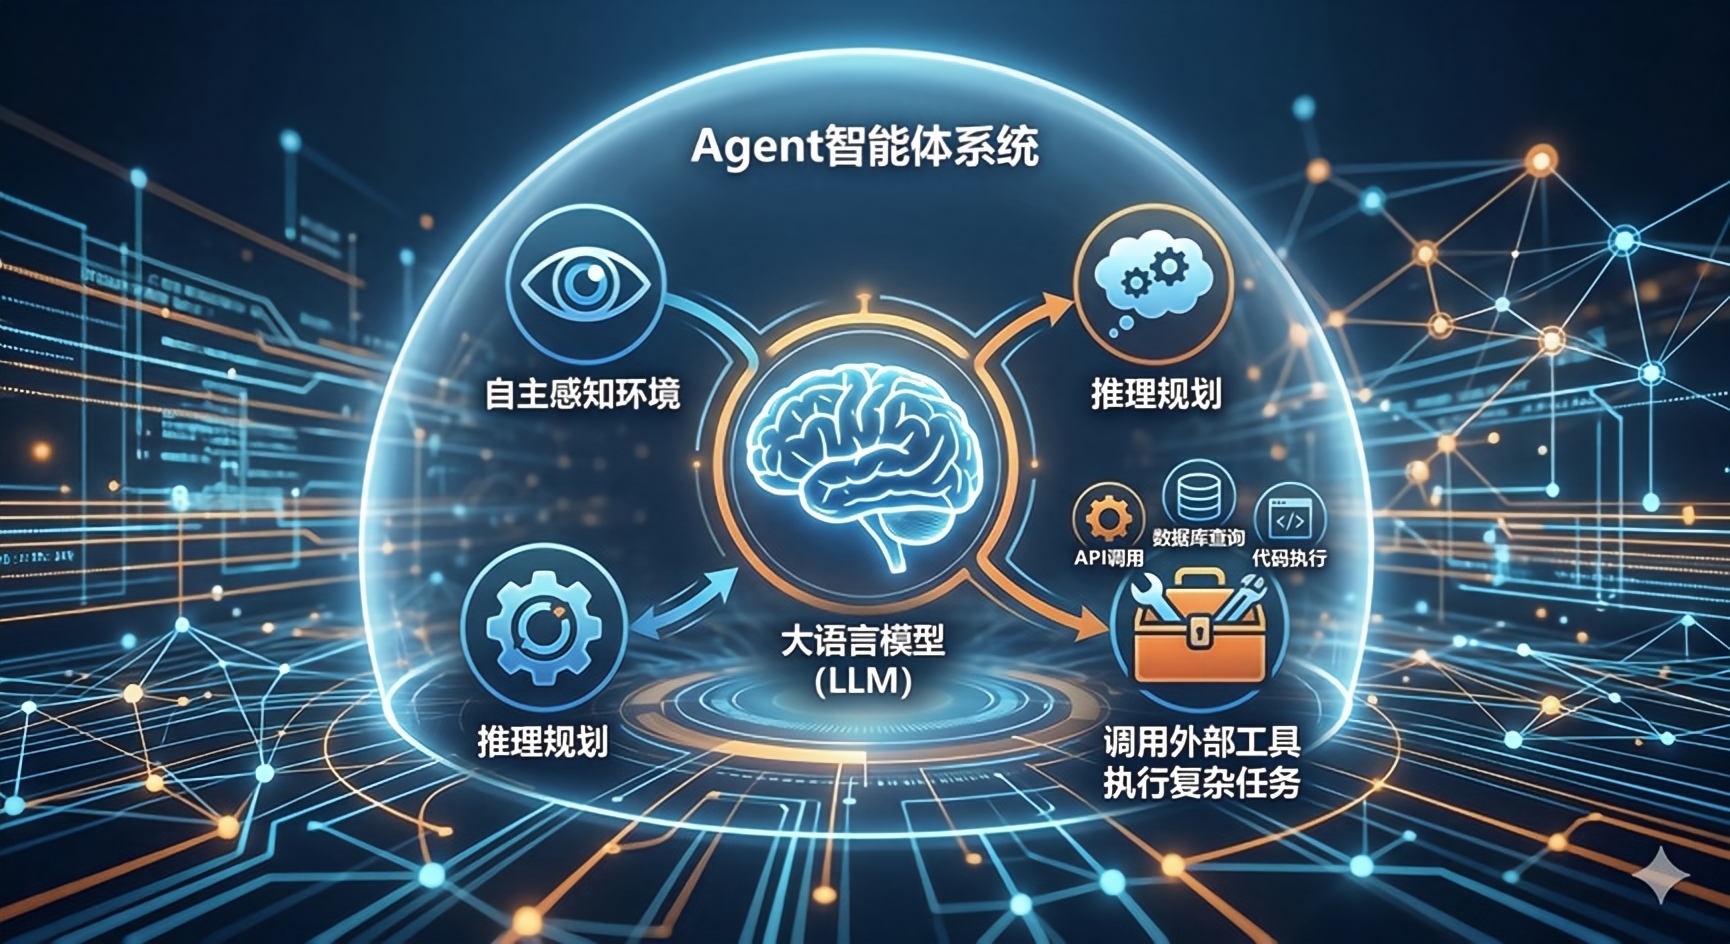
AI平台承载着大规模分布式训练与推理业务,围绕GPU/NPU利用率提升、平台稳定性加固、运维效率升级三大核心目标,已系统性地推进了AI Agent体系建设,先后落地了训练任务智能排障Agent、性能分析Agent、推理服务智能诊断Agent、模型发布链路排障等多个Agent,并探索了多Agent协作的架构。
本次课程将结合企业AI平台团队在AI Infra领域的Agent工程实践,重点讲解Agent体系的架构设计思路、关键工具与技能(Skills/MCP)的开发方法、从单点Agent到多Agent协同的演进路径,以及真实业务场景下的落地效果与经验教训,为有志于在AI Infra领域引入智能运维的团队提供参考。
课程收益
1、分享一套AI Agent场景选型框架—什么场景值得做Agent、什么场景不适合?判断标准是什么?随听随用;
2、分享可复用的三层Agent架构模板—路由Agent → 专家Agent → 原子能力Agent,含Skills/MCP开发方法,可直接参考;
3、分享真实落地避坑清单—工具建设、Prompt调优、闭环设计上踩过的坑,帮你少走弯路;
4、分享训练排障、GPU性能分析、推理诊断、模型发布链路四大核心场景落地,4个实战Agent,并已探索多Agent协作架构,形成完整覆盖而非零散尝试;
5、掌握分层架构可复用理念,“路由Agent → 专家Agent → 原子能力Agent”三层设计,有工程落地实操细节,可借鉴,可复用;
6、真实落地效果与可复用方法论,既有具体场景问题处置Case,利用率分析和提升等量化结果,提炼出“选场景、建工具、调Prompt、做闭环、看数据”五要素方法论。
受众人群
从事AI平台架构设计、AI基础设施、云原生AI平台、架构创新、AI Infra领域的架构设计专家、CTO、团队负责人,以及其他对AI Infra、架构设计感兴趣的从业者。
课程周期
0.5天(3H)
课程大纲
章节 | 授课内容 |
一、为什么AI Infra需要Agent? | 内容详解 |
二、我们的Agent建设之路 | 1、从零开始:从简单场景入手构建第一个Agent(训练任务智能排障) 2、快速复制:模型发布链路排障Agent+管控面稳定性Agent 3、信心增强,上难度:体系化构建GPU/NPU性能分析Agent 4、复杂场景挖掘:多Agent协同解决复杂问题 |
三、经验总结与可复用方法论 | 1、经验总结 2、可复用的方法 |
四、后续规划与开放问题 | 1、国产NPU适配过程中Agent的作用与挑战 2、算力利用率归因Agent经验 3、更大规模的多Agent协同(Event Agent → 根因分析 → 故障处置闭环) |


 京ICP备2022035414号-1


